[AI를 찾아서] 2편
큰 거 왔냐?
AI WrittenEdited by Injeong
- 규칙파의 전성기, 전문가 시스템 (1980년대)
- 두 번째 겨울 (1987년~1990년대 초)
- 겨울 속 반격, 역전파
- 신경망, 처음으로 돈을 벌다
- 봄을 부른 세 가지: 데이터, GPU, 알고리즘
(앞 편에서 이어서) 첫 겨울을 먼저 빠져나온 쪽은 규칙파였다. 이번에는 연구실이나 정부가 아니라 기업이 지갑을 열었다.
2-1. 규칙파의 전성기, 전문가 시스템 (1980년대)
모든걸 전부 다 잘해줘ㅜㅜ << 난 한 놈만 패
규칙파(기호주의)가 겨울을 빠져나온 방법은 목표를 확 줄이는 것이었다. 모든 일을 하는 기계는 포기하고, 한 분야의 전문가가 하는 판단만 따라 하게 했다. 범위가 좁으면 필요한 규칙도 수백~수천 개로 끝나고, 당시 컴퓨터로도 돌릴 수 있었다. 이것이 '전문가 시스템(Expert System)'이다.
전문가 시스템은 두 부분으로 나뉜다. 전문가에게 물어서 받아 적은 규칙을 모아 둔 '지식 베이스', 그리고 상황이 주어지면 규칙을 하나씩 맞춰 보며 결론을 내는 '추론 엔진'이다. 규칙은 전문가가, 따라가는 건 기계가 한다.
MYCIN, 혈액 감염을 진단하다.
가장 유명한 전문가 시스템은 1970년대 미국 스탠퍼드대에서 만든 MYCIN(마이신)이다. 환자의 검사 결과를 넣으면 혈액 감염을 일으킨 세균을 추측하고, 어떤 항생제를 얼마나 쓸지 권했다. 규칙은 약 600개였고, "만약 세균이 그람음성이고, 막대 모양이고, 산소 없이 자라면, 그 세균은 아마도 박테로이데스다" 같은 식이었다.
성적도 좋았다. 1979년 평가에서 MYCIN의 처방은 스탠퍼드 의대 교수들의 처방과 비슷하거나 더 나은 점수를 받았다. 그런데도 MYCIN은 실제 병원에서는 거의 쓰이지 못했다. 오진이 나면 책임을 누가 지는지 정해지지 않았고, 의사가 검사 결과를 하나하나 입력하는 데만 30분 가까이 걸렸기 때문이다.
XCON, AI가 기업의 돈을 아껴줬다.
병원에서는 막혔지만 기업에서는 성공 사례가 나왔다. 주인공은 DEC(디지털 이큅먼트)다. DEC는 1957년 세워진 미국 컴퓨터 회사로, IBM의 방 하나만 한 대형 컴퓨터보다 작고 싼 '미니컴퓨터'로 크게 성공한 회사다.
DEC의 골칫거리는 주문 처리였다. 주력 컴퓨터 모델인 VAX는 고객마다 고르는 부품 조합이 달랐고, 어떤 부품을 어느 자리에 꼽고 어떤 케이블이 더 필요한지 따지는 일을 기술자가 손으로 했다. 하나라도 빠뜨리면 고객에게 간 컴퓨터가 조립되지 않았다.
1980년 미국 카네기멜론대와 DEC가 함께 만든 XCON은 이 일을 규칙으로 대신했다. 주문을 넣으면 빠진 부품을 채우고 배치까지 정해 줬다. 규칙은 처음 약 750개에서 1980년대 중반 수천 개로 늘었고, DEC는 이 덕에 해마다 수천만 달러를 아꼈다고 알려져 있다(대략치). "AI로 돈을 벌 수 있다"는 걸 처음 보여 준 사례였다.
기업과 국가가 몰려들다.
XCON 이야기가 퍼지자 미국 대기업들이 앞다투어 전문가 시스템을 만들었다. 1985년 무렵에는 기업들이 AI에 쓰는 돈이 한 해 10억 달러를 넘었다(대략치). 국가도 뛰어들었다. 1982년 일본 통상산업성은 '제5세대 컴퓨터' 프로젝트를 시작했다. 사람처럼 추론하는 컴퓨터를 10년 안에 만들겠다는 목표였고, 후지쓰·NEC·히타치 같은 일본 전자회사들이 연구원을 보냈다.
당시는 일본이 반도체 메모리에서 미국을 누르던 때다. [반도체를 찾아서]에서 본 DRAM 점유율 역전이 이 무렵이다. 그래서 미국과 영국은 "컴퓨터도 일본에 질라"는 위기감에 각자 큰 AI 연구 사업을 만들어 맞불을 놓았다. 첫 겨울에 끊겼던 돈이 다시 들어온 것이다.
LISP 머신, AI 전용 컴퓨터.
돈이 돌자 AI를 돌리는 전용 컴퓨터를 파는 회사들도 생겼다. 당시 AI 프로그램은 대부분 1958년 매카시가 만든 LISP이라는 프로그래밍 언어로 짰는데, 일반 컴퓨터에서는 LISP이 느리게 돌았다. 그래서 LISP을 빠르게 돌리도록 하드웨어부터 설계한 'LISP 머신'이 나왔다.
대표 회사가 1980년 MIT AI 연구소 사람들이 나와 세운 미국의 심볼릭스(Symbolics)다. 심볼릭스는 1985년 인터넷 역사상 첫 번째 .com 주소(symbolics.com)를 등록한 회사로도 유명하다.(와! 상식 하나 추가!) 그만큼 잘나가던 회사였다.
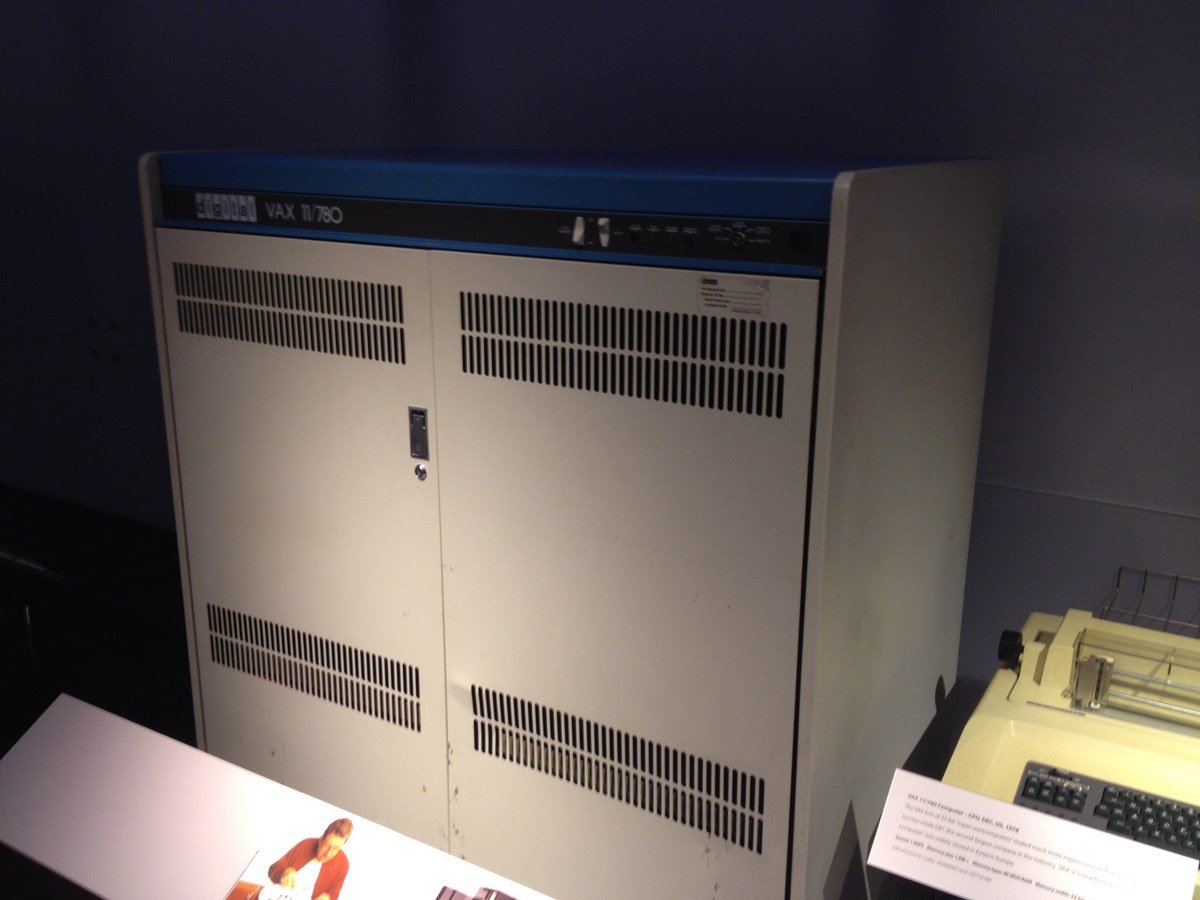
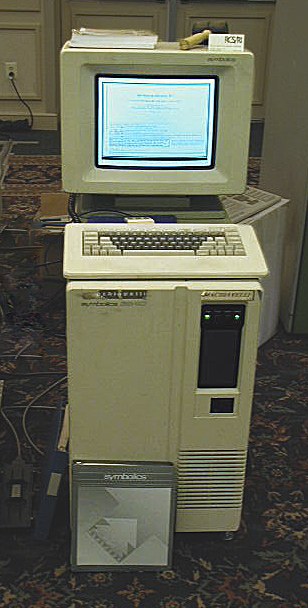
① DEC VAX-11/780(1977년 출시). XCON이 주문마다 부품 구성을 짜 준 바로 그 컴퓨터 계열. ② 심볼릭스 3640. 1980년대 AI 전용 LISP 머신.
하지만 규칙으로 지은 이 호황은 흔들거리는 다리 위에 있었다. 규칙이 늘어날수록, 또 전용 컴퓨터가 비쌀수록 다리는 더욱 위태위태해졌다.
2-2. 두 번째 겨울 (1987년~1990년대 초)
1987년, LISP 머신 시장의 붕괴.
다리가 먼저 무너진 곳은 하드웨어였다. 1980년대 중반이 되자 썬 마이크로시스템즈(Sun Microsystems, 미국, 1982년 설립, 엔지니어용 워크스테이션 회사)의 범용 컴퓨터와 애플·IBM의 PC가 빠르게 좋아졌다. [반도체를 찾아서]에서 본 무어의 법칙 덕분에, 일반 컴퓨터가 몇 년 만에 LISP을 충분히 빠르게 돌릴 수 있게 된 것이다.
그러자 훨씬 비싼 전용 기계를 살 이유가 사라졌다. 1987년 한 해 동안 LISP 머신 시장이 통째로 무너졌고, 약 5억 달러 규모의 산업이 1년 만에 범용 컴퓨터로 대체됐다고 한다(대략치). 한때 .com 주소 1호였던 심볼릭스는 1993년 파산했다. 전용 칩·전용 기계는 범용 칩이 따라오는 속도보다 빨리 좋아지지 않으면 사라진다는 교훈이다.
규칙이 늘어날수록 관리가 안 됐다.
더 큰 문제는 전문가 시스템 자체에 있었다. 첫째, 규칙은 스스로 늘지 않는다. 새 제품이 나오거나 상황이 바뀌면 사람이 규칙을 고치고 더해야 했다. XCON도 규칙이 수천 개로 불어나자 그것만 관리하는 전담 팀이 필요했고, 새 규칙이 옛 규칙과 부딪히면 어디서 틀렸는지 찾기도 어려웠다.
둘째, 전문가도 자기 지식을 다 꺼내 적지 못한다. 노련한 의사에게 "왜 이 환자는 수상해 보였나요?"라고 물으면 대부분 "그냥 느낌이 그랬다"고 답한다. 수많은 경험이 머릿속에서 감각으로 바뀐 것이라, if-then 문장으로 옮기려고 하면 빈틈이 생긴다. 그리고 규칙에 없는 상황이 오면 전문가 시스템은 엉뚱한 답을 내거나 아예 멈췄다.
생명줄이 '또' 빠져나갔다...
기대가 꺾이자 돈은 첫 겨울 때처럼 빠르게 빠져나갔다. 미국 DARPA는 1980년대 말 AI 지원을 크게 줄였고, 일본 제5세대 컴퓨터 프로젝트는 1992년 처음 목표에 한참 못 미친 채 끝났다. 기업들은 'AI'라는 말을 피해 '데이터 분석', '의사결정 지원' 같은 다른 이름을 붙여 연구를 이어 갔다. 1987년부터 1990년대 초중반까지를 '두 번째 AI 겨울'이라고 부른다.
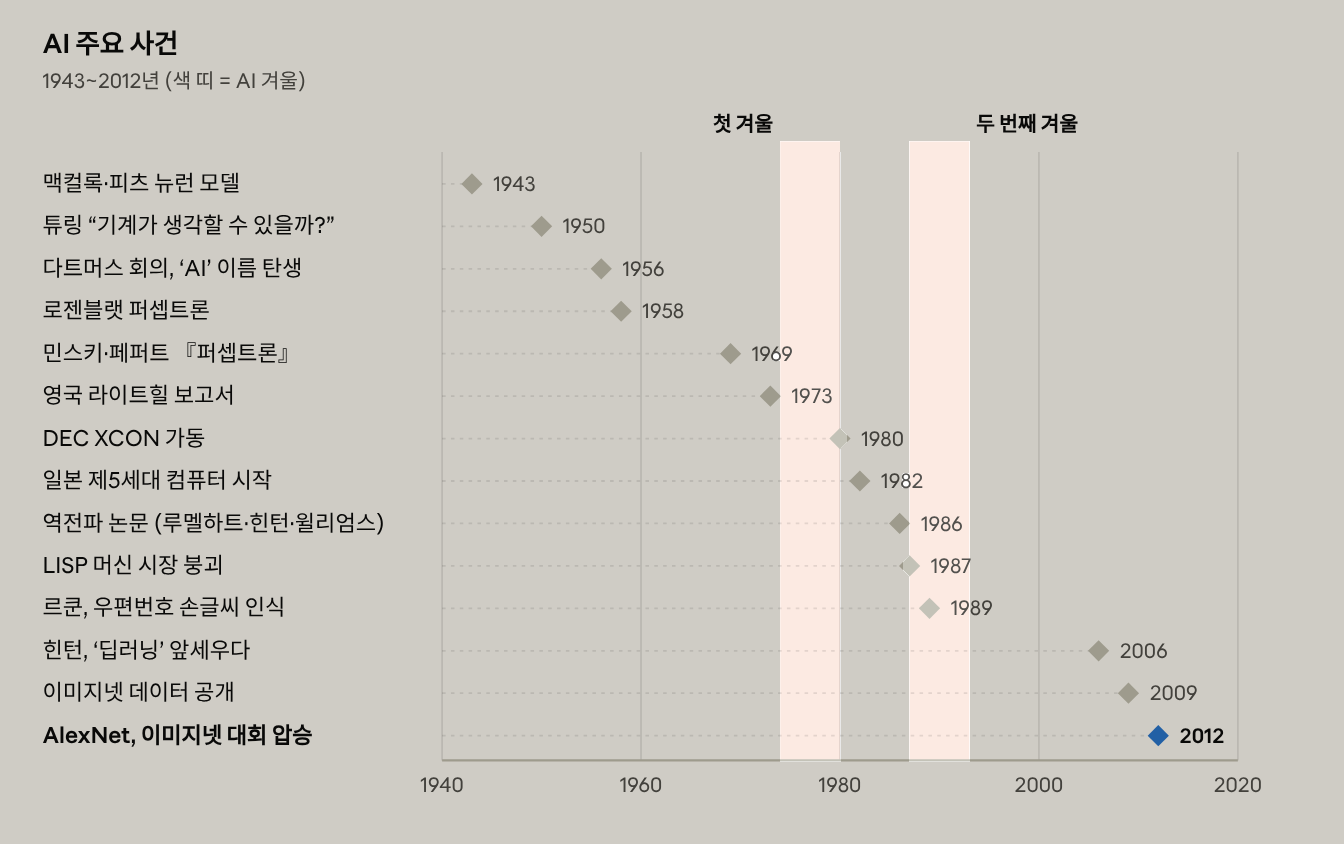
그렇다고 규칙파가 남긴 게 없는 것은 아니다. 지금도 은행 대출 심사, 보험 인수 심사, 회사 결재 시스템 같은 곳에는 "연체 이력이 있으면 거절" 같은 규칙 엔진이 돌아간다. 다만 '지능'이라고 부르지 않을 뿐이다. 그리고 규칙파가 두 번째 겨울에 들어가던 바로 그 무렵, 숨죽이고 있던 연결파(뇌를 그냥 만들어버리자!파)는 조용히 다시 일어나고 있었다.
2-3. 겨울 속 반격, 역전파
1986년, 여러 층을 가르치는 법.
연결주의가 다시 일어난 계기는, 민스키가 남겨 둔 그 숙제를 푼 것이었다. 뉴런을 여러 층으로 쌓으면 XOR도 풀 수 있는데, 그 여러 층을 어떻게 가르칠 것인가. 1986년 과학 잡지 『네이처』에 실린 논문이 그 방법을 널리 알렸다. 이름하여 '역전파(Backpropagation)'다.
인물 소개: 역전파 논문의 세 사람
데이비드 루멜하트(David Rumelhart): 미국, 캘리포니아대 샌디에이고 심리학자. 사람의 생각을 신경망으로 설명하려 했다.
제프리 힌턴(Geoffrey Hinton): 영국 출신, 당시 미국 카네기멜론대 교수. 나중에 캐나다 토론토대로 옮겨 딥러닝을 이끈다.
로널드 윌리엄스(Ronald Williams): 미국, 당시 샌디에이고 연구원. 후에 강화학습 연구로도 이름을 남겼다.
비슷한 아이디어는 그 전에도 있었다. 1960년대 로켓 궤도(비행 경로) 계산 같은 제어 이론에서 비슷한 계산법이 쓰였고, 1974년 미국의 폴 웨르보스(Paul Werbos)가 박사 논문에서 신경망에 적용하자고 제안했다. 하지만 겨울 한가운데라 아무도 주목하지 않았고, 1986년 논문이 실제 실험으로 "된다"는 걸 보여 주면서 비로소 퍼졌다.
참고로 1982년 존 홉필드(John Hopfield)가 역전파를 만들었다고 적힌 자료도 있는데, 틀린 내용이다. 미국 칼텍의 물리학자 홉필드는 기억을 저장하는 다른 종류의 신경망을 만들었고, 2024년 힌턴과 함께 노벨 물리학상을 받았다.
왜 층을 쌓아야 했나.
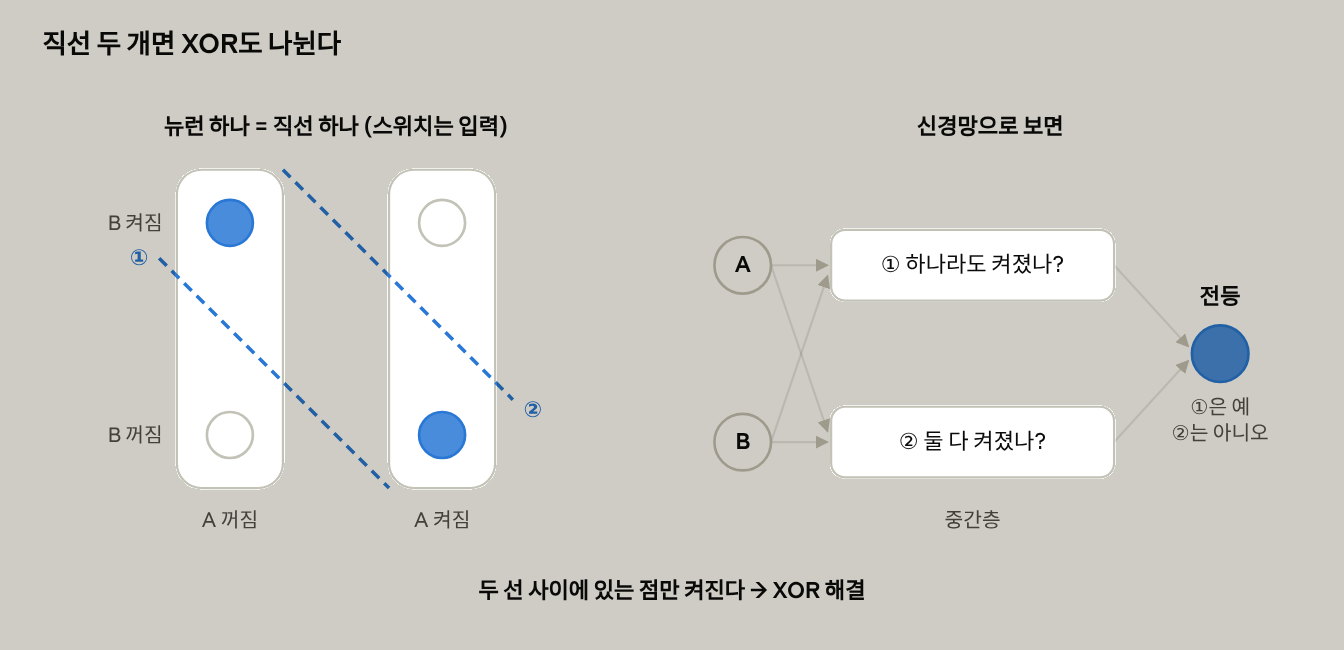
다시 XOR로 돌아가 보자. 뉴런 하나가 하는 일은 '예/아니오' 질문 하나에 답하는 것이고, 이걸 평면에 그리면 직선 하나로 '예'와 '아니오'를 가르는 것이다. 직선이 경계선이고, 한쪽에 있는 점은 전부 '예', 반대쪽은 전부 '아니오'다. 그래서 뉴런 하나짜리 퍼셉트론은 XOR을 못 풀었다. 그런데 중간에 뉴런을 두 개 두면 이야기가 달라진다. 뉴런 ①은 스위치를 보고 'A나 B 중 하나라도 켜졌나?'에, 뉴런 ②는 'A와 B가 둘 다 켜졌나?'에 답한다. 마지막 뉴런은 스위치를 직접 보지 않고 ①②의 답만 본다. '①은 예, ②는 아니오'일 때 전등을 켜면, 그게 바로 XOR이다. 한 번에 못 푸는 어려운 질문을, 직선 하나로 풀 수 있는 쉬운 질문 여러 개로 쪼갠 것이다. 층을 쌓을수록 이렇게 쪼개고 조합하는 일을 여러 번 할 수 있어서, 훨씬 복잡한 문제도 풀 수 있다. 사진 속 고양이를 알아보는 것도 같은 원리다. 앞 층은 선과 모서리를, 다음 층은 눈·귀 같은 부분을, 마지막 층은 고양이 전체를 본다.
다른 해결책도 있긴 했다. 첫째, 사람이 입력을 미리 가공해 주는 방법. 'A와 B가 둘 다 켜졌나'라는 새 입력을 사람이 넣어 주면 퍼셉트론 하나로도 XOR이 풀린다. 하지만 문제마다 사람이 이런 특징을 일일이 설계해야 해서, 결국 기호주의처럼 사람 손이 많이 간다. 둘째, 데이터를 수학적으로 변환해 직선으로 나뉘게 만드는 방법. 1990년대에 나온 '서포트 벡터 머신(SVM)'이 대표적이고, 실제로 2000년대 중반까지는 이쪽이 신경망보다 잘 나갔다. 층을 쌓는 방식이 달랐던 점은 '어떤 특징을 볼지'까지 기계가 데이터에서 스스로 배운다는 것이다. 문제는 그 여러 층을 어떻게 가르치느냐였고, 그 답이 역전파다.
역전파는 무엇을 하나.
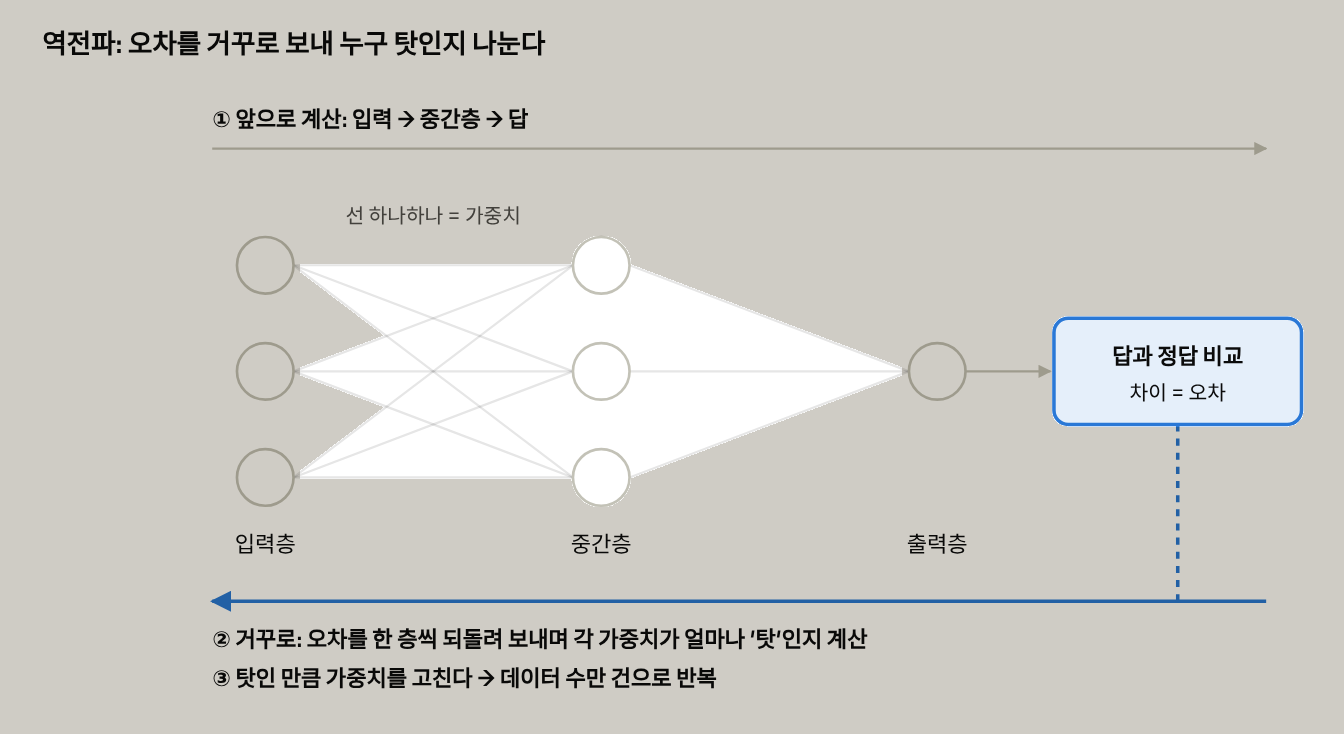
다시 1980년대, 역전파의 시작으로 돌아가보자. 역전파가 푸는 문제는 '누구 탓인가'다. 층이 하나일 때는 틀리면 그 층의 가중치를 고치면 됐다. 층이 여럿이면 마지막 답이 틀렸을 때 중간층의 수많은 가중치 중 무엇을 얼마나 고쳐야 할지 알 수가 없다.
역전파는 이름 그대로 오차를 뒤로(역) 전해 보낸다(전파). 먼저 출력에서 정답과의 차이(오차)를 구한다. 그리고 그 오차를 한 층씩 거꾸로 돌려 보내면서, 각 가중치가 오차에 얼마나 기여했는지를 계산하고, 기여한 만큼 가중치를 고친다. 이걸 데이터 수만 건에 대해 반복하면 여러 층 전체가 조금씩 정답 쪽으로 맞춰진다. 자세한 모양은 이후 시리즈에서 신경망을 따로 다룰 때 본다.
2-4. 신경망, 처음으로 돈을 벌다
벨연구소의 수표 읽는 기계.
역전파는 곧 돈이 되는 일에 쓰였다. 프랑스 출신 연구자 얀 르쿤(Yann LeCun)은 1988년 미국 통신회사 AT&T의 벨연구소에 들어갔다. 벨연구소는 트랜지스터가 태어난 그 연구소다. 르쿤은 그림을 작은 조각으로 훑어 보는 신경망(합성곱 신경망)을 역전파로 가르쳐, 1989년 미국 우편번호 손글씨를 읽게 했다.
이 기술은 은행 수표로 이어졌다. 수표에 손으로 쓴 금액을 읽는 시스템이 은행에 팔렸고, 1990년대 말에는 미국에서 처리되는 수표의 10% 이상을 신경망이 읽었다고 한다(대략치). 규칙으로는 사람마다 다른 손글씨를 다 적을 수 없었지만, 정답이 붙은 예시를 많이 보여 주면 신경망은 배울 수 있었다. 이처럼 문제와 정답을 같이 보여 주며 가르치는 방식을 '지도학습'이라고 한다.
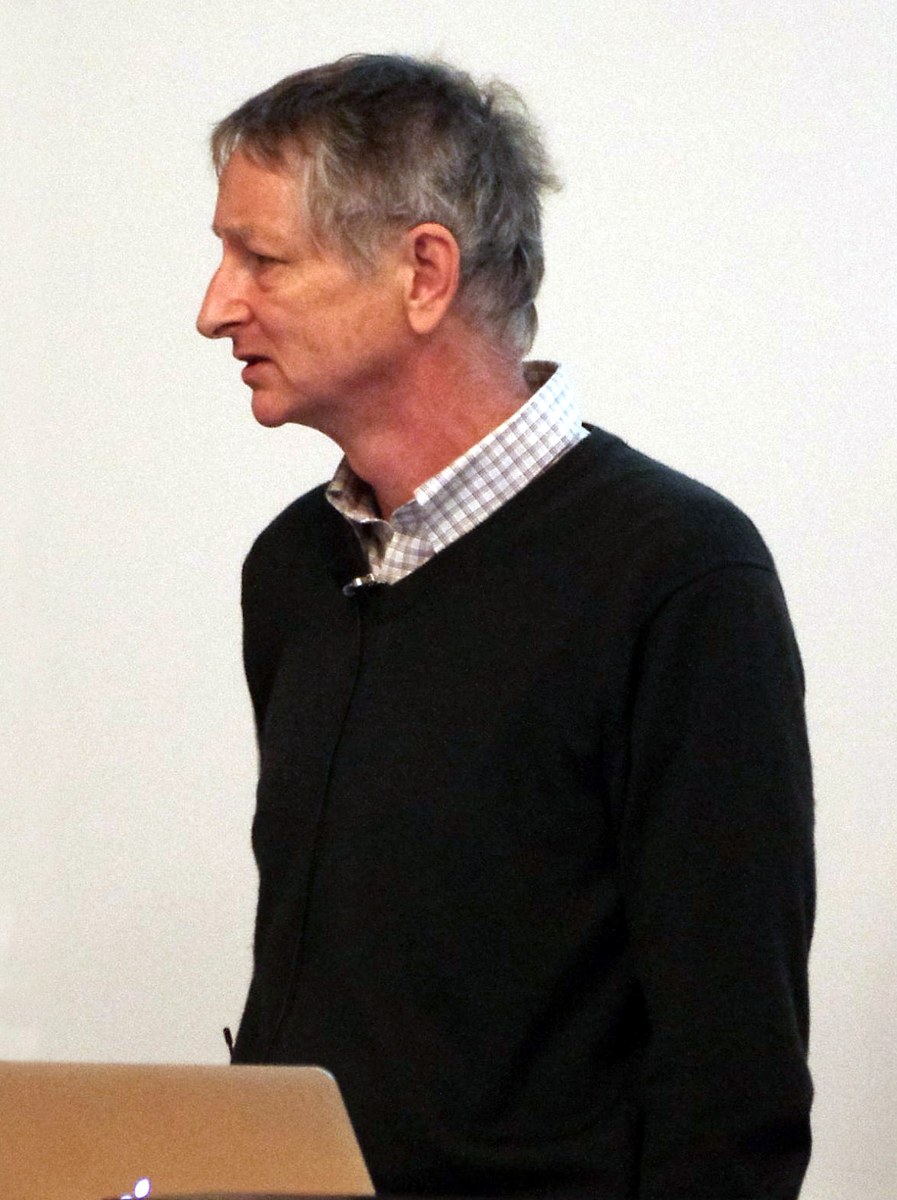
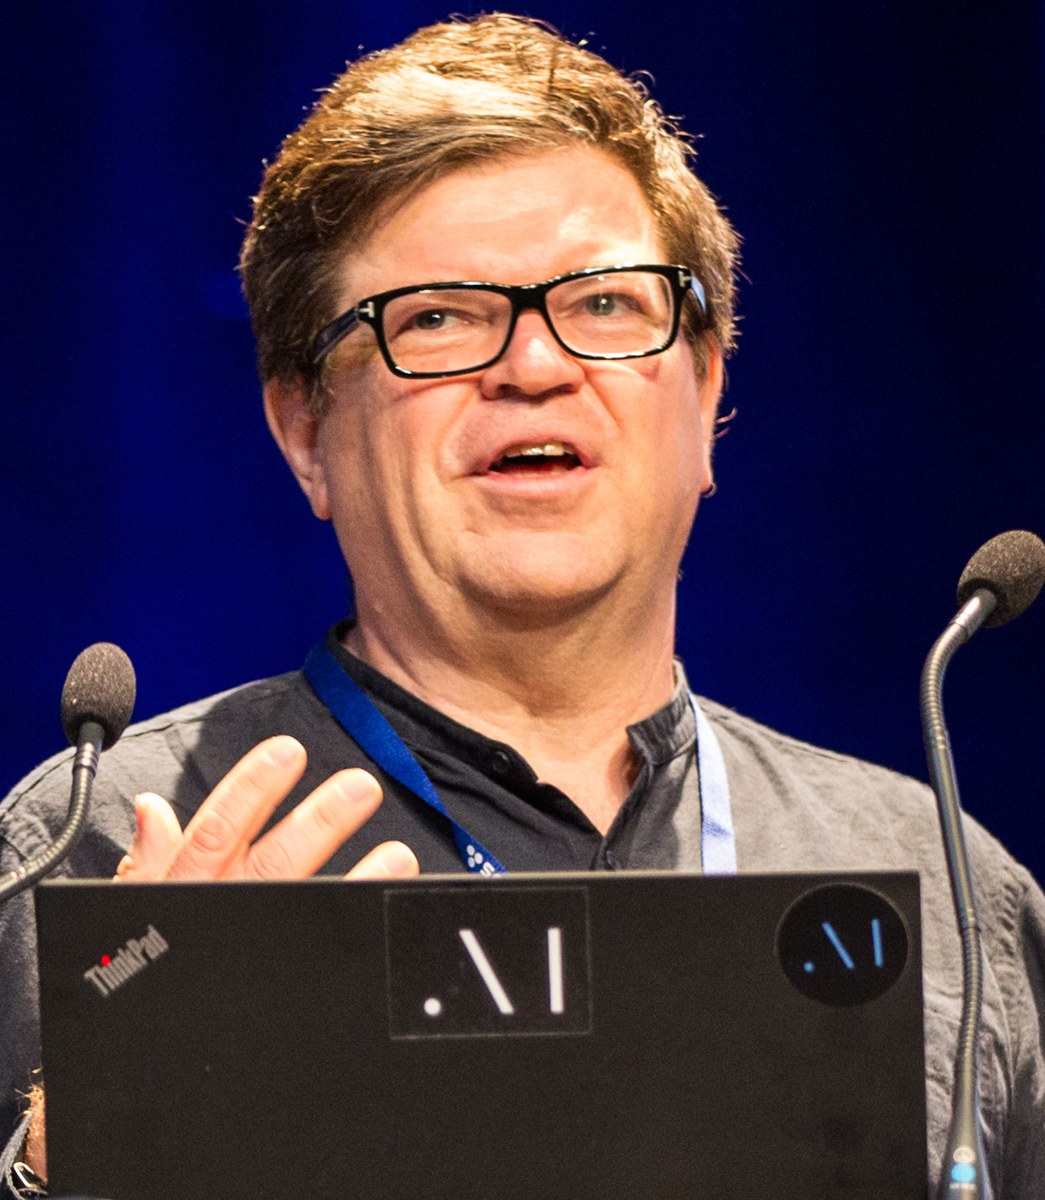
① 제프리 힌턴, 2013년 강연. 역전파 논문의 공저자이자 딥러닝의 대부. ② 얀 르쿤, 2018년. 벨연구소에서 손글씨 읽는 신경망을 만들었다.
카드사의 사기 탐지.
금융에서도 쓰임새가 나왔다. 미국 회사 HNC 소프트웨어(신경망 연구자 로버트 헥트닐슨의 신경망 전문 회사)는 1992년 신경망으로 신용카드 사기 거래를 잡는 'Falcon'을 내놓았다. 평소 쓰던 가게·금액·시간대와 다른 거래가 들어오면 점수를 매겨 바로 막는 식이다. 사기 수법은 계속 바뀌어 규칙으로 따라가기 어렵지만, 신경망은 새 데이터로 다시 배우면 됐다. 신용점수 회사 FICO가 2002년 HNC를 사들였고, Falcon은 지금도 전 세계 카드사들이 쓴다.
그런데 왜 바로 붐이 오지 않은 이유는?
여기까지 오면 1990년대에 신경망 세상이 왔어야 할 것 같다. 하지만 층을 깊게 쌓을수록 오차가 뒤로 갈수록 희미해져서 앞쪽 층이 거의 배우지 못하는 문제가 있었다. 컴퓨터는 여전히 느렸고, 수표 숫자 같은 좁은 문제를 넘어서는 데이터도 모자랐다. 1990년대에는 수학적으로 깔끔한 다른 머신러닝 방법들이 성적이 더 좋았기 때문에(앞서 설명했던 SVM 등), 신경망은 다시 뒤로 밀렸다.
그럼에도 힌턴, 르쿤, 그리고 캐나다 몬트리올대의 요슈아 벤지오(Yoshua Bengio) 같은 소수만 신경망을 붙들고 있었다. 그리고 세 사람은 훗날 2018년 컴퓨터과학의 노벨상이라는 튜링상을 함께 받는다. 이들에게 부족했던 것은 아이디어가 아니라, 데이터와 계산력이었다.
2-5. 봄을 부른 세 가지: 데이터, GPU, 알고리즘
쓸 수 있는 데이터가 늘었다.
부족했던 두 가지 중 데이터는 인터넷이 채워 줬다. 2000년대에 들어 사람들이 사진을 올리고, 글을 쓰고, 물건을 사면서 엄청난 기록이 쌓였다. 다만 기계가 배우려면 "이 사진은 고양이"처럼 정답이 붙은 데이터가 필요했다.
이 일을 해낸 사람이 중국계 미국인 컴퓨터과학자 페이페이 리(Fei-Fei Li)다. 프린스턴대에서 2007년 시작한 '이미지넷(ImageNet)'은 인터넷 사진 1,400만 장 이상에 사람이 일일이 이름표를 붙인 데이터다. 이름표 붙이기는 아마존의 온라인 부업 서비스(메커니컬 터크)를 통해 전 세계 사람들에게 나눠 맡겼다. 2010년부터는 이 데이터로 사진 분류 실력을 겨루는 대회가 해마다 열렸다.
둘, 게임용 그래픽카드의 변신
나머지 하나인 계산력(computing power)은 뜻밖의 곳에서 왔다. 엔비디아(NVIDIA)는 1993년 미국에서 세워져 PC 게임용 그래픽카드를 만들던 회사다. 그래픽카드의 칩인 GPU는 화면의 수백만 개 점(픽셀) 색을 동시에 계산하려고, 단순한 계산을 한꺼번에 엄청나게 많이 하도록 만들어졌다.
그런데 신경망이 하는 일도 마찬가지다. 입력에 가중치를 곱해서 더하는 단순한 계산을 수억 번 되풀이한다. 복잡한 일을 하나씩 빨리 처리하는 CPU보다, 단순한 일을 수천 개씩 동시에 하는 GPU가 훨씬 잘 맞았다. 엔비디아가 2007년 GPU를 게임이 아닌 일반 계산에도 쓸 수 있게 해 주는 도구 CUDA(쿠다)를 내놓으면서, 연구자들이 게임용 카드로 신경망을 돌리기 시작했다.
마지막 단추, 깊은 층을 가르치는 요령.
마지막은 알고리즘이다. 고양이 사진 같은 복잡한 문제일수록 질문을 더 여러 단계로 쪼개야 해서(선 → 모양 → 눈·귀 → 고양이), 층을 깊게 쌓아야 했다. 그런데 층이 깊어질수록 역전파의 오차가 앞쪽 층까지 거의 전달되지 않아 학습이 잘 안 됐다. 2006년 힌턴은 층을 한 층씩 미리 가르친 뒤 쌓으면 깊은 신경망도 학습이 된다는 논문을 내며 '딥러닝'이라는 이름을 앞세웠다. 이후 오차가 뒤로 갈수록 희미해지는 문제를 줄이는 요령들이 하나씩 나왔다. 1990년대에 발목을 잡았던 문제가 풀리기 시작한 것이다.
2012년, 세 가지가 한꺼번에 만났다.
2012년 이미지넷 대회에서 유전이 터졌다. 토론토대 힌턴 연구실의 대학원생 알렉스 크리제브스키(Alex Krizhevsky)와 일리야 수츠케버(Ilya Sutskever)가 만든 신경망 'AlexNet'은 이미지넷 사진 약 120만 장을 엔비디아 게임용 그래픽카드 2장으로 일주일 남짓 학습했다.
결과는 차이가 컸다. 다섯 번 안에 정답을 맞히지 못한 비율이 AlexNet은 약 15%, 2등은 약 26%였다. 해마다 몇 %p씩 줄던 대회에서 10%p 가까이를 한 번에 줄인 것이다. 다음 해부터 상위권 팀은 거의 다 신경망으로 바꿨다. AlexNet이 어떻게 생겼고 왜 그렇게 잘했는지는 또 커밍 쑨...
그리고 반도체.
이 한 번의 대회가 산업의 판을 바꿨다. 신경망은 더 크고 더 깊어질수록 잘했고, 더 크게 만들려면 GPU가 더 많이 필요했다. 게임용 칩 회사였던 엔비디아는 AI 칩 회사가 됐고, GPU 옆에 붙는 고대역폭 메모리(HBM)를 만드는 SK하이닉스·삼성전자까지 그 흐름에 올라탔다. [반도체를 찾아서]에서 본 AI 붐의 출발점이 바로 여기다.
돌아보면 70년 싸움의 승자는 연결주의다. 다만 이긴 이유는 생각이 더 옳아서라기보다, 데이터와 계산력이 마침내 따라와 줬기 때문이다. 그리고 두 번의 겨울이 남긴 교훈도 있다. 기대가 실력보다 크게 부풀면, 돈은 그만큼 빨리 빠져나간다.
그럼 지금은 기호주의 연구 없나?
있다. 주인공 자리를 내주고 무대 뒤로 갔을 뿐이다. 구글 검색 오른쪽에 뜨는 인물·장소 정보 칸은 '지식 그래프'라는, 사람이 정리한 사실과 관계의 묶음(기호주의)에서 나온다. 반도체 칩 설계가 맞는지 수학적으로 검증하는 도구도 규칙과 논리로 돈다. 요즘은 아예 둘을 섞는 '신경-기호(Neuro-symbolic) AI'도 연구된다. 2024년 구글 딥마인드의 알파지오메트리(AlphaGeometry)는 신경망이 '여기에 보조선을 그어 보자'는 제안 내면, 규칙 기반 추론 엔진이 그걸 한 줄씩 증명하는 식으로 국제수학올림피아드 기하 문제를 풀기도 했다. 언젠가 또 기호주의의 봄이 올지도?!
다음 편에서는 현재까지의 최후의 승자!, '데이터로 배우는 기계'가 정확히 무엇인지 들여다본다. 머신러닝은 어떤 종류가 있고, 기계가 잘 배웠는지는 어떻게 채점하며, 시험 문제만 외운 학생처럼 '과적합'에 빠지는 건 언제인지를 본다.
[AI를 찾아서] 3편. 머신러닝? 딥러닝? 알파고 그거 아님?
사진 출처
- DEC VAX-11/780: Punteador, CC BY-SA 4.0, https://commons.wikimedia.org/wiki/File:Computer_History_Museum_%E2%80%93_DEC_VAX-11-780.jpg
- 심볼릭스 3640: Michael L. Umbricht, Carl R. Friend (Retro-Computing Society of Rhode Island), CC BY-SA 3.0, https://commons.wikimedia.org/wiki/File:Symbolics3640_Modified.JPG
- 제프리 힌턴(2013): Eviatar Bach, CC BY-SA 3.0, https://commons.wikimedia.org/wiki/File:Geoffrey_Hinton_at_UBC.jpg
- 얀 르쿤(2018): Jérémy Barande / École polytechnique, CC BY-SA 2.0, https://commons.wikimedia.org/wiki/File:Yann_LeCun_-_2018_(cropped).jpg


참고 자료
- Rumelhart, Hinton, Williams, "Learning representations by back-propagating errors", Nature(1986): https://www.nature.com/articles/323533a0
- Krizhevsky, Sutskever, Hinton, "ImageNet Classification with Deep Convolutional Neural Networks"(2012): https://papers.nips.cc/paper/4824-imagenet-classification-with-deep-convolutional-neural-networks
- 2024년 노벨 물리학상(홉필드·힌턴): https://www.nobelprize.org/prizes/physics/2024/summary/
- 2018년 튜링상(벤지오·힌턴·르쿤): https://awards.acm.org/about/2018-turing